
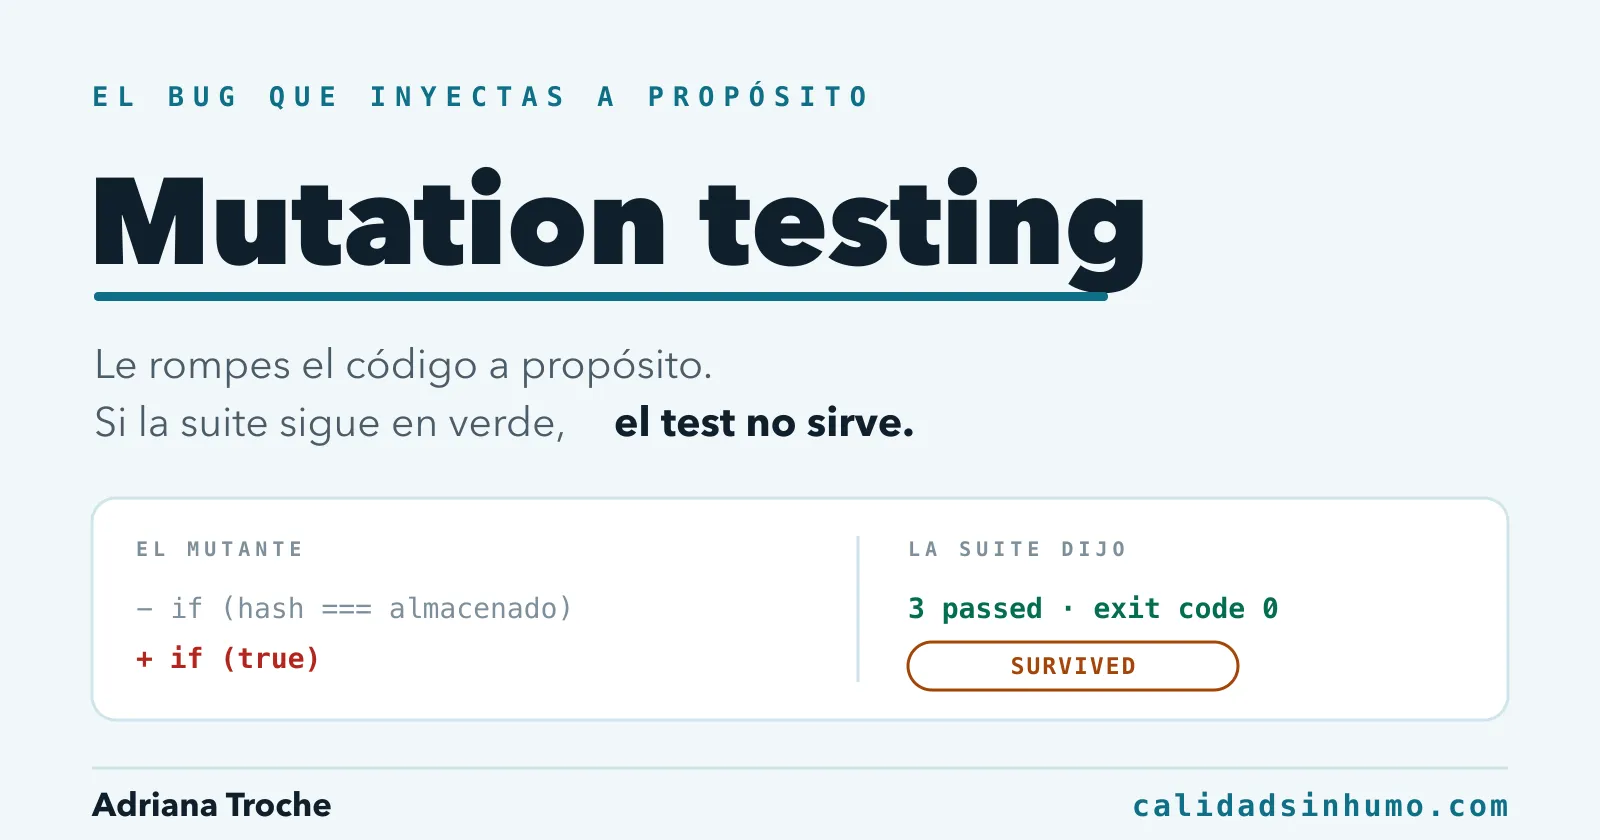
Le quité al backend de mi playground la línea que compara la contraseña.
Una línea. Con eso, cualquiera entraba con el email de otra persona y la clave que se le ocurriera. Es el bug más caro que puede tener un login.
Después corrí la suite de tests.
3 passed, 2 skippedExit code 0Verde. Un pipeline con esa suite habría dejado pasar ese deploy sin una sola alarma, con el bypass de autenticación vivo en el código.
El playground es el de Academia sin Humo: una aplicación que mantengo con 17 bugs sembrados a propósito para practicar automatización, cada uno ligado a una técnica ISTQB. Es gratis y no pide registro. Si quieres practicar sobre el mismo login de este artículo, está abierto.
Esto no es una parada de ninguna serie. Es la continuación directa de Mutation Testing: lo que aprendí implementándolo de verdad —conviene leer ese primero si nunca corriste un mutante— aplicada al problema que no existía cuando lo escribí: la mitad de los tests que revisas hoy no los escribió una persona. Al final hay dos gates concretos, uno por capa, y una tabla armada para que se la reenvíes a quien firma el release.
El experimento ya tenía nombre y yo no lo estaba usando
Ese bypass no fue un accidente. Lo inyecté yo, a propósito, para ver si los agentes de Playwright eran capaces de detectarlo. Conté el resultado completo en Probé los 3 agentes de Playwright.
Lo que no dije ahí —porque no lo había visto— es que ese experimento tiene un nombre viejo y una disciplina detrás.
Un bug que introduces a propósito en el código para ver si tus tests lo atrapan es un mutante. Yo escribí uno, a mano, elegido a dedo. Mutation testing es hacer exactamente eso, pero de forma sistemática: una herramienta le mete cientos de bugs artificiales a tu código, uno por uno, corre tu suite contra cada uno y cuenta cuántos sobrevivieron.
Un mutante que sobrevive no es un problema del código. Es un problema del test que lo dejó pasar.
Cuando corrí esto en serio, sobre un archivo de utilidades con lógica de negocio real, fueron 248 mutantes y un score de 95.16%. Ese proceso encontró 3 bugs que ya habían pasado code review. La técnica no es nueva ni experimental: Google la corre sobre más de mil proyectos internos.
Lo nuevo es para qué la necesitas ahora.
Qué cambió: el que escribe los tests dejó de ser una persona
Esta parte del artículo no la pensé sola, y prefiero decirlo antes de usarla.
La disparó Escribir código dejó de ser el cuello de botella. Verificarlo, no, de Alejandro Lafourcade. Su tesis: la IA aceleró la producción de código y dejó intacta la capacidad de verificarlo, así que el cuello de botella se corrió de lugar. Lo leí, me quedé con la sensación de que estaba describiendo desde el lado del arquitecto exactamente lo que yo había visto desde el lado del QA, y de ahí salió todo lo que sigue.
En el camino lista cinco tests que pasan sin probar nada. Los nombra así:
- El que verifica el mock, no el sistema
- El que se calcula la respuesta a sí mismo
- El 200 OK
- El que depende de hoy
- El que pasa por el orden en que corre
Lee esa lista otra vez pensando en tu repo. Yo la leí pensando en el mío.
El blog se llama Ingeniería sin
filtros y lo escribe Alejandro Lafourcade, arquitecto
de software. Ahí está corriendo #100ArchitectureDays: una serie larga sobre
arquitectura y producción donde cada entrada agarra un solo tema —el nombre de
una variable, un boolean de parámetro, YAGNI, herencia contra composición— y
lo pelea hasta el final en vez de resumirlo en una lista de diez puntos.
Está escrito para devs, y por eso conviene que lo leas si haces QA: es la mesa de al lado. Cuando entiendes por qué un equipo eligió una arquitectura, entiendes por qué su suite es cara de mantener. Su frase de portada podría estar colgada acá: “El código ya lo escribe la IA. El criterio para decidir qué construir, cómo sostenerlo en producción y por qué, todavía lo construís vos.” Él lo llama ingeniería sin filtros y yo calidad sin humo. Es la misma pelea contra lo mismo.
Tiene razón en el diagnóstico, y esa lista es exactamente lo que un QA con oficio detecta leyendo un PR. El problema es de escala: detectarlos leyendo funciona cuando entran diez tests por semana escritos por tres personas que conoces. No funciona cuando entran doscientos, generados en tres minutos, sintácticamente impecables y sin una sola pista visual de cuál de los cinco patrones tienen adentro.
Ahí es donde la lista cualitativa necesita un instrumento que la vuelva número. Y el instrumento existe desde hace décadas.
“Este test no prueba nada” es una opinión que se discute en un code review. “Este test no mató el mutante” es un hecho que se ve en un reporte. Es la misma afirmación, medida.
Tres formas de pasar sin probar nada, todas medidas en mi playground
Cuando corrí los tres agentes de Playwright contra mi propio login, cada uno falló de una manera distinta. Vistas hoy, las tres son el mismo problema:
El planner declaró por escrito que no tenía oráculo. En dos escenarios del plan que generó escribió: “Documentar el comportamiento observado: si el backend hace trim, el login es exitoso; si no, se rechaza. Cualquiera de los dos es aceptable siempre que sea consistente”. Detectó la pregunta y la devolvió, porque la respuesta no estaba dentro de la aplicación.
El generator descartó en silencio lo que no se ve en pantalla. El plan pedía verificar el status 401 de POST /api/login. El test que produjo trae cuatro assertions de interfaz y ninguna del 401. Es el patrón “El 200 OK” de la lista de Lafourcade, en su versión más limpia: nadie lo escribió mal, simplemente se cayó.
El healer llegó al verde silenciando. Contra lo que yo esperaba, no falseó los valores esperados. Diagnosticó bien, corrió un experimento de control por su cuenta y marcó los dos tests con test.fixme() y un comentario correcto. Su prompt se lo pide: “do the most reasonable thing possible to pass the test”.
El oráculo no desapareció con los agentes. Quedó degradado a comentario de código: correcto, escrito, y sin ningún poder para frenar un merge.
Lo que este artículo no te puede esconder
Mutation testing no aplica a tus tests E2E. Lo escribí en el artículo de marzo y sigue siendo cierto: mutar el código fuente y volver a levantar un browser por cada mutante es inviable, y ninguna de las herramientas serias lo intenta.
Eso deja un hueco incómodo, porque buena parte de lo que hoy generan los agentes son justamente tests E2E.
Así que no hay un gate. Hay dos, y se eligen por capa.
Las dos capas casi nunca tienen el mismo dueño. Los unit tests los escribe el equipo de desarrollo, y cada vez más la IA que ese equipo usa. Los E2E suelen ser territorio de QA. Eso cambia tu papel en cada gate: en el primero no escribes ni un test, mides y propones; en el segundo lo haces tú de punta a punta.
Gate 1: mutation score, con el umbral que casi nadie configura
Stryker trae tres umbrales. El que importa es el tercero:
{ "testRunner": "jest", "mutate": ["src/services/**/*.ts", "src/utils/**/*.ts"], "incremental": true, "thresholds": { "high": 80, "low": 60, "break": 60 }}high y low solo pintan el reporte de verde o naranja. break es el único que tiene consecuencias: si el mutation score baja de ese valor, Stryker termina con exit code 1 y el build falla.
Su valor por defecto es null. Es decir: si no lo tocas, corriste mutation testing y no pusiste ningún gate. Generaste un informe bonito que nadie va a leer dos veces.
Si eres QA, Stryker lo puedes correr tú sobre el repositorio del equipo sin escribir un solo unit test: generas el reporte y lo lees. El break, en cambio, se pone con el equipo, porque ese gate va a frenar sus PRs, no los tuyos. Tu parte es llegar a esa conversación con el score real ya medido.
No arranques con break en 80 sobre todo el repo. La primera corrida completa
puede tardar horas y el número inicial te va a doler. Empieza con mutate
apuntado al módulo más crítico, mide el score real que tienes hoy, y pon
break en ese número. A partir de ahí solo puede subir: cualquier PR que
empeore la suite rompe el build sin discusión.
Con incremental: true las corridas siguientes reutilizan el resultado guardado y solo evalúan lo que cambió, que es lo que hace viable meterlo en cada PR y no solo en el nocturno.
El mutante que sobrevive y no es tu culpa
Existen los mutantes equivalentes: mutaciones que no cambian el
comportamiento real del programa, así que ningún test podría matarlas.
Aparecen como survived y no representan un problema. Por eso el score
perfecto no es la meta y por eso el umbral se calibra con tu número real en
vez de con uno aspiracional sacado de un blog.
Gate 2: sabotaje dirigido, para todo lo que no se puede mutar
Esto es lo que yo hice sin saber que lo estaba haciendo, convertido en protocolo. La herramienta no existe: la herramienta eres tú, una rama y quince minutos.
- Elige cinco bugs por riesgo, no por facilidad. No “un typo en un label”. Los cinco que, si llegan a producción, te obligan a escribir un incidente: el que abre autenticación, el que cobra de más, el que muestra datos de otro usuario, el que pierde el registro, el que rompe el flujo que factura.
- Inyecta uno solo, en una rama descartable. Un bug por corrida. Dos a la vez y no sabes cuál atrapó la suite.
- Corre la suite completa y anota el exit code, no la impresión. Verde y rojo, sin interpretación.
- Revierte siempre. La rama se tira. Esto no se mergea nunca, ni “por un rato”.
- Anota qué test lo atrapó. Si ninguno, ya sabes cuál es el test que falta escribir — y lo sabes con el bug concreto en la mano, que es la mejor forma de escribirlo.
El resultado cabe en una tabla:
| Bug inyectado | ¿La suite se puso roja? | Test que lo atrapó |
|---|---|---|
| Se quita la comparación de contraseña | No | — |
| El total del carrito ignora el descuento | Sí | checkout.spec.ts:41 |
| El listado devuelve pedidos de otro usuario | No | — |
| El webhook de pago no marca la orden como pagada | Sí | payments.spec.ts:88 |
| El formulario guarda con el campo obligatorio vacío | Sí | form.spec.ts:12 |
Dos de cinco sin detectar. Eso no es una opinión sobre la suite. Es un experimento con resultado.
Lo que le llevas a quien firma el release
Nadie reenvía un artículo a su jefe. Todos reenvían un número que lo obliga a decidir algo.
Compara las dos frases que puedes llevar a la reunión donde se decide si el release sale:
La primera cierra la conversación con una sensación de seguridad. La segunda la abre, y la abre con evidencia: nadie discute un experimento reproducible, y nadie firma tranquilo después de escucharlo.
Esa tabla es el artefacto. No pide presupuesto, no pide contratar a nadie y no habla de “mejorar la calidad”. Dice qué está desprotegido, con nombre y apellido, y deja la decisión donde corresponde.
Si además quieres el diagnóstico completo de la suite y no solo de este punto, la rúbrica de siete dimensiones es el instrumento largo — y ahí puedes ver cómo saqué 15 sobre 21 con mi propia suite.
Qué puedes hacer esta semana
Sin pedir permiso ni abrir una iniciativa:
- Si tu equipo tiene unit tests: corre Stryker sobre un módulo crítico (no necesitas escribir ningún test para eso), anota el score real y llévalo a la retro o al refinamiento como propuesta de
break. El gate lo activa quien mantiene el pipeline; el número lo traes tú. - Si solo tienes E2E: elige un bug de los caros, inyéctalo en una rama, corre la suite y anota el exit code. Toma quince minutos y te da la primera fila de la tabla.
- Si estás revisando tests generados por IA: antes de aprobar el PR, rompe a propósito la función que ese test dice cubrir. Si el test sigue en verde, no estás aprobando un test. Estás aprobando una línea que dice que hay un test.
La IA puede escribir el test, y cada vez lo escribe mejor. Lo que no puede hacer es demostrar que ese test detecta algo — porque para eso hay que romper el sistema a propósito, y decidir qué vale la pena romper es un criterio, no una generación.